Продуктовый дизайнер по имени Эми Чжоу представила приложение Lipflow, которое читает по губам и превращает беззвучную речь в текст. Код проекта написан на Python и опубликован на GitHub под лицензией MIT.
«Хотелось пользоваться голосовым вводом, не мешая окружающим, поэтому я сделал приложение для распознавания речи по губам», — пояснила Чжоу.
Для работы с инструментом нужно смотреть в камеру и произносить нужную фразу одними губами. Решение распознаёт слова и печатает их за пользователя.
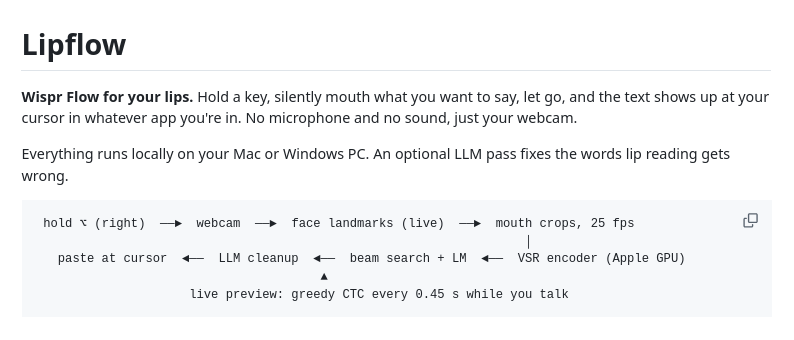
«Удерживайте клавишу, тихо произнесите то, что хотите сказать, отпустите, и текст появится под курсором в любом приложении, в котором вы находитесь. Ни микрофона, ни звука, только веб‑камера. Все работает локально на вашем Mac или ПК с Windows. Дополнительный проход LLM исправляет ошибки при чтении слов по губам», — уточнила Чжоу.
Произносить речь без звука (лишь имитируя движения губ) сложнее, чем говорить вслух перед камерой, поскольку артикуляция при этом менее выражена; поэтому при записи на собственную веб-камеру стоит ожидать большего количества ошибок. Именно для их исправления и используются LLM.
Принцип работы проекта:
-
модель Auto-AVSR (система визуального распознавания речи), обученная на датасете LRS3 (показатель WER 19,1% на тестовом наборе). Входной блок на базе ResNet с 3D-свертками и энкодер Conformer передают данные декодеру Transformer и блоку CTC (Connectionist Temporal Classification); при поиске beam search используется языковая модель Transformer, работающая с подсловами (subwords).
-
предварительная обработка: MediaPipe FaceLandmarker работает с каждым кадром непосредственно во время записи, поэтому повторный этап обнаружения не требуется. Опорные точки (глаза, основание носа, углы рта) выравниваются относительно усреднённого лица из обучающей выборки, после чего фрагменты изображения области рта (размером 96×96 пикселей, в оттенках серого) приводятся к частоте 25 кадров в секунду, ожидаемой моделью.
-
скорость (на чипе M4 Pro, фраза длительностью 9 с): энкодер — 0,16 с на GPU Apple (на CPU — 1,7 с); поиск по лучу — около 0,8–1,6 с на CPU (это быстрее, чем использование MPS, из-за большого количества мелких операций); итого от момента завершения записи до получения текста проходит около 1–2 с. Ускорить процесс помогли два изменения, внесённые в используемую библиотеку ESPnet: ключи и значения (keys/values) механизма cross-attention вычисляются один раз для всей фразы, а не для каждой гипотезы на каждом шаге (что ускорило beam search на 25%), а расчёт оценок CTC стал возможен на любом устройстве.
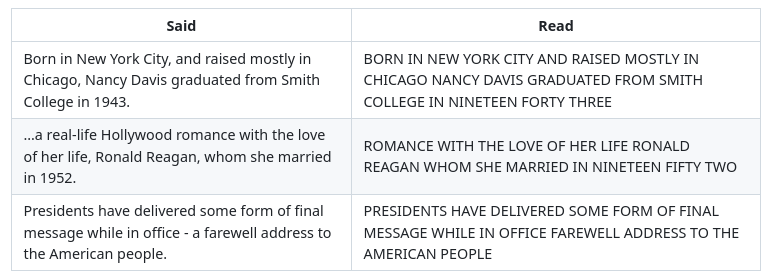
Точность на отложенной выборке новостных видеоматериалов (находящиеся в общественном достоянии обращения из Белого дома), необработанный выходной результат модели: